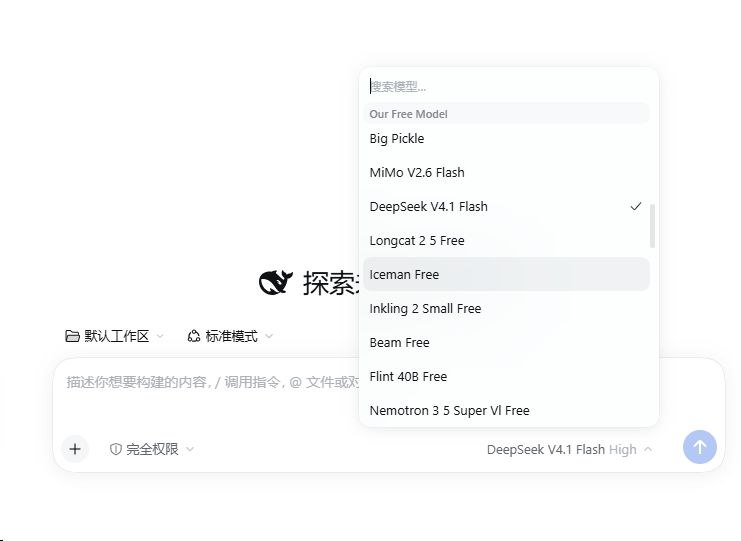
DeepSeek Harness 接入免费大模型
DeepSeek Harness 接入免费大模型:dsh-our-free-model 插件实测思路
说明:本文涉及的仓库地址、安装命令与具体参数,请以对应仓库 README 与官方文档为准。若你检索不到 dsh-our-free-model 的公开仓库,说明它可能尚未公开发布或名称有差异,请以你实际获取的插件来源为准,本文不臆造链接与数据。DeepSeek Harness 是什么
DeepSeek Harness(下文简称 Harness)可以理解为围绕 DeepSeek 系列模型构建的运行与编排外壳:它把模型调用、上下文管理、工具/插件挂载、会话与配置管理收拢到一处,让开发者不必在每个脚本里重复写请求封装、重试逻辑和环境变量读取。它的定位更接近「本地或团队内的模型工作台」,而不是一个单纯的 SDK。
适用人群大致有三类:
- 独立开发者与小团队:想快速把大模型接进自己的脚本、内部工具或原型,但不想维护一套调用层。
- 需要多模型切换的实验者:同一任务要在不同模型间对比效果、成本与延迟。
- 企业内部工具的搭建者:需要统一的配置入口、可插拔的能力扩展,以及相对可控的调用边界。
典型场景包括:本地批量文本处理、内部知识问答原型、Agent 类任务的工具编排、以及把模型能力嵌入已有 CLI/服务中做验证。
免费大模型接入的实际痛点
「免费模型」听起来很美好,落地时通常卡在三个地方。
第一是配置繁琐。 不同厂商的免费额度往往对应不同的 Base URL、鉴权方式、模型命名规范,有的还要求特定的请求头或参数。每接一个模型就要改一次配置、试一次连通性,脚本里散落着各种 if provider == ... 的分支。
第二是模型切换成本高。 免费模型的能力差异很大:有的擅长长文本,有的响应快但质量一般,有的对中文更友好。想在同一任务上做 A/B 对比,手工改配置既慢又容易出错,切换后还要重新验证上下文长度、超时与重试策略是否兼容。
第三是额度与稳定性不确定。 免费额度通常伴随速率限制、并发上限和随时可能调整的可用性。一旦某个模型临时不可用,手工配置的方案往往直接报错中断,缺乏自动降级或路由能力。
这三点叠加,导致「免费」在时间成本上并不真的免费。
dsh-our-free-model 插件的作用边界
按标题描述,dsh-our-free-model 是一个让 Harness 调用免费大模型的插件。它的价值在于把「接入免费模型」这件事从一次性手工劳动,变成可复用、可集中管理的配置能力。
它解决的是:
- 把免费模型的接入方式收敛到插件层,减少在业务代码里散落的 provider 判断;
- 提供相对统一的配置入口,降低新增/替换模型的边际成本;
- 在 Harness 的插件机制内完成模型选择与调用衔接,便于和其他插件能力组合。
它不解决的是:
- 不改变免费模型本身的额度、速率与可用性——免费就是免费,限制依然存在;
- 不保证输出质量,模型能力差异仍需你自己评估;
- 不替代你对数据隐私与合规的判断;
- 不承诺长期兼容,插件与上游 API 都可能变化。
一句话:它是接入层的便利工具,不是能力与额度的放大器。
安装与启用流程要点
由于具体命令必须以仓库 README 为准,这里只给流程骨架,避免照抄未经核实的指令:
- 确认前置条件:Harness 的版本、插件加载方式(配置文件、命令行还是包管理器)、运行环境(Node/Python 等)是否满足插件要求。
- 获取插件:通过仓库 README 指定的渠道安装(可能是包管理器、源码克隆或插件市场),注意核对来源与版本号。
- 配置凭据与模型清单:按文档填写免费模型所需的鉴权信息与模型标识,建议用环境变量或本地配置管理,避免硬编码进仓库。
- 启用并验证:先做一次最小连通性测试(单条短请求),确认路由到预期模型,再逐步接入实际任务。
- 记录回滚方式:保留旧配置,便于插件异常时快速退回手工配置。
如果 README 提供了示例配置文件,优先照抄其结构再改值,比从零手写更稳妥。
核心功能与技术亮点
- 插件化接入:把模型接入做成插件,与 Harness 主流程解耦,升级与替换不影响业务代码主体。
- 模型路由:在多个免费模型之间做选择或切换,便于按任务、按成本或按可用性分流(具体路由粒度以 README 为准)。
- 配置集中管理:把分散的 Base URL、鉴权、模型名收拢到一处,降低维护成本与出错概率。
- 可替换性:当某个免费模型下线或限流,替换配置即可,不必重写调用逻辑。
- 与 Harness 生态组合:作为插件,理论上可与其他插件能力叠加使用,形成更完整的本地工作流。
需要提醒:以上亮点是基于「插件化接入免费模型」这一常见设计推断的功能方向,具体实现细节、是否支持自动降级、路由策略可配置到什么程度,均以仓库 README 为准。
适用场景与优缺点分析
适合的场景:个人原型验证、内部工具的模型接入层、需要频繁对比多模型的实验、对成本敏感但可接受不稳定性的非关键任务。
优点:接入成本低、切换灵活、配置集中、与 Harness 生态协同。
缺点:免费模型的质量与稳定性不可控;插件本身的成熟度、文档完整度和长期维护情况需要观察;出问题时排查链路比直连多一层。
与手工配置对比:手工配置透明、可控、无额外依赖,但每加一个模型都要重复劳动,切换成本高。插件适合模型数量多、切换频繁的场景;只用一个模型且长期不变时,手工配置反而更简单。
与其他聚合网关方案对比:聚合网关通常提供统一 API、跨厂商路由与配额管理,能力更全但引入额外网络跳转与信任边界;本插件更贴近 Harness 本地工作流,轻量但覆盖面有限。选择取决于你更看重「统一入口」还是「本地轻量」。
风险与注意事项
- 免费额度:额度可能随时调整或取消,不要把关键业务建立在免费额度上。
- 速率限制:并发与 QPS 限制会影响批量任务,需设计重试与退避。
- 数据隐私:请求会发往第三方服务,敏感数据不要送入免费通道;确认数据是否被用于训练。
- 许可协议:插件本身的许可证、以及各免费模型服务的使用条款都要读一遍,商用前尤其注意。
- 供应链风险:插件来源需可信,安装前核对仓库与发布者。
上手建议与后续演进
建议按「小步验证 → 扩大范围 → 团队落地」推进:
- 小规模验证:先用单条请求跑通链路,再跑一批真实但非敏感的任务,记录成功率、延迟与输出质量。
- 建立对比基线:同一批任务同时跑手工配置与插件配置,确认行为一致后再切换。
- 补齐可观测性:记录每次调用的模型、耗时与失败原因,便于定位是插件问题还是上游限流。
- 团队落地:把配置纳入版本管理(凭据除外),写明回滚步骤与责任人;对关键任务保留付费模型或本地模型的兜底通道。
后续演进上,可关注插件是否支持更细的路由策略、失败自动降级、以及配置热更新。这些能力决定了它能否从「个人便利工具」走向「团队基础设施」。在官方文档更新前,一切以仓库 README 为准,避免基于推测做架构决策。